AI/DIGITAL / 2026.09.23
26/09/23 GPT-5.6とGPT-6の6モデルを公式ベンチマークで比べてみた|Luna・Terra・Sol・Astra
GPT-5.6 SolとGPT-6 Solの違いを調べたら、Luna同士や5.6 Terra、6 Astraも並べた時にどう見えるのか気になりました
そこでOpenAIの発表とAPI仕様を確認したのですが、6モデルを1つの点数で順位付けするのは危ない。
同じ名前のテストでも、発表日や推論の強さが違う数字が混ざります
この記事は2026年9月23日時点の公式資料に基づく比較です。同じ作業を6モデルに依頼した実測結果ではありません
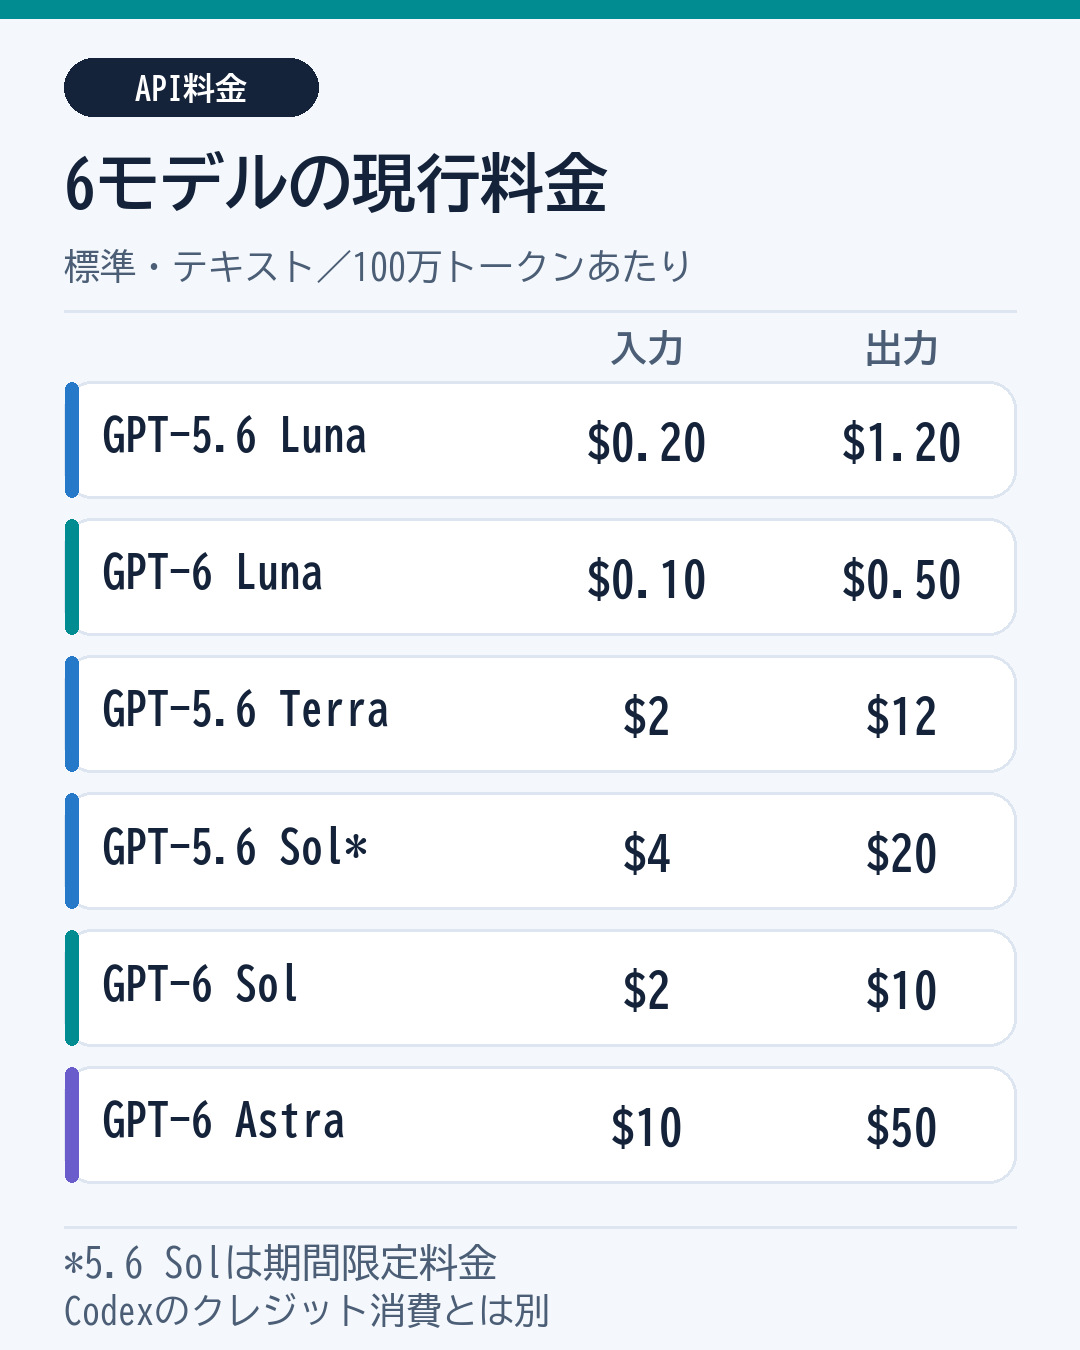
まず6モデルの位置づけと料金
| モデル | OpenAIが示す主な用途 | API入力 / 出力料金 |
|---|---|---|
| GPT-5.6 Luna | 低コストで大量に処理する仕事 | $0.20 / $1.20 |
| GPT-6 Luna | 範囲のはっきりした作業を効率よく大量に処理 | $0.10 / $0.50 |
| GPT-5.6 Terra | 性能と費用のバランス | $2.00 / $12.00 |
| GPT-5.6 Sol | 複雑な専門業務 | $4.00 / $20.00 |
| GPT-6 Sol | 複雑なコーディングとエージェント作業 | $2.00 / $10.00 |
| GPT-6 Astra | 特に難しい仕事を最初から最後まで進める | $10.00 / $50.00 |
料金は標準処理で入力・出力それぞれ100万トークンあたりの米ドル価格です。272,000入力トークン超、キャッシュ、Fastなどは別条件で、Codexアプリの利用枠をドル換算した表ではありません。GPT-5.6 Solの$4 / $20は、少なくとも2026年11月21日までのプロモーション価格とされています。用途と料金はOpenAIのモデル比較、GPT-6 Sol・Luna発表、GPT-5.6 Sol仕様で照合しました
価格だけなら、GPT-6 LunaはGPT-5.6 Lunaより入力が半額、出力は約58%安い。GPT-6 SolはGPT-5.6 Solの半額で、GPT-5.6 Terraと比べても入力は同額、出力は安くなっています。ただし、実際の1件あたりの費用は出力トークン、再試行、確認作業でも変わります。OpenAIも「成功した仕事1件の総費用」で見る考え方を示しています
3段階の並びと価格帯なら、6 Solは5.6 Terraがいた中間の位置に近いです。ただし、性能までTerra相当という意味ではありません。OpenAIは6 Solを複雑なコーディング向けとし、5.6 Solより事実の信頼性や説明の明瞭さが上がったと案内しています。Codexのモデル案内
なお、API仕様上のコンテキスト上限は6モデルとも105万トークン、最大出力は12.8万トークンです。これは読める量の上限であって、長文を正しく理解できる性能が同じという意味ではありません。各モデルのAPI仕様
公式ベンチマークの数字を見てみる
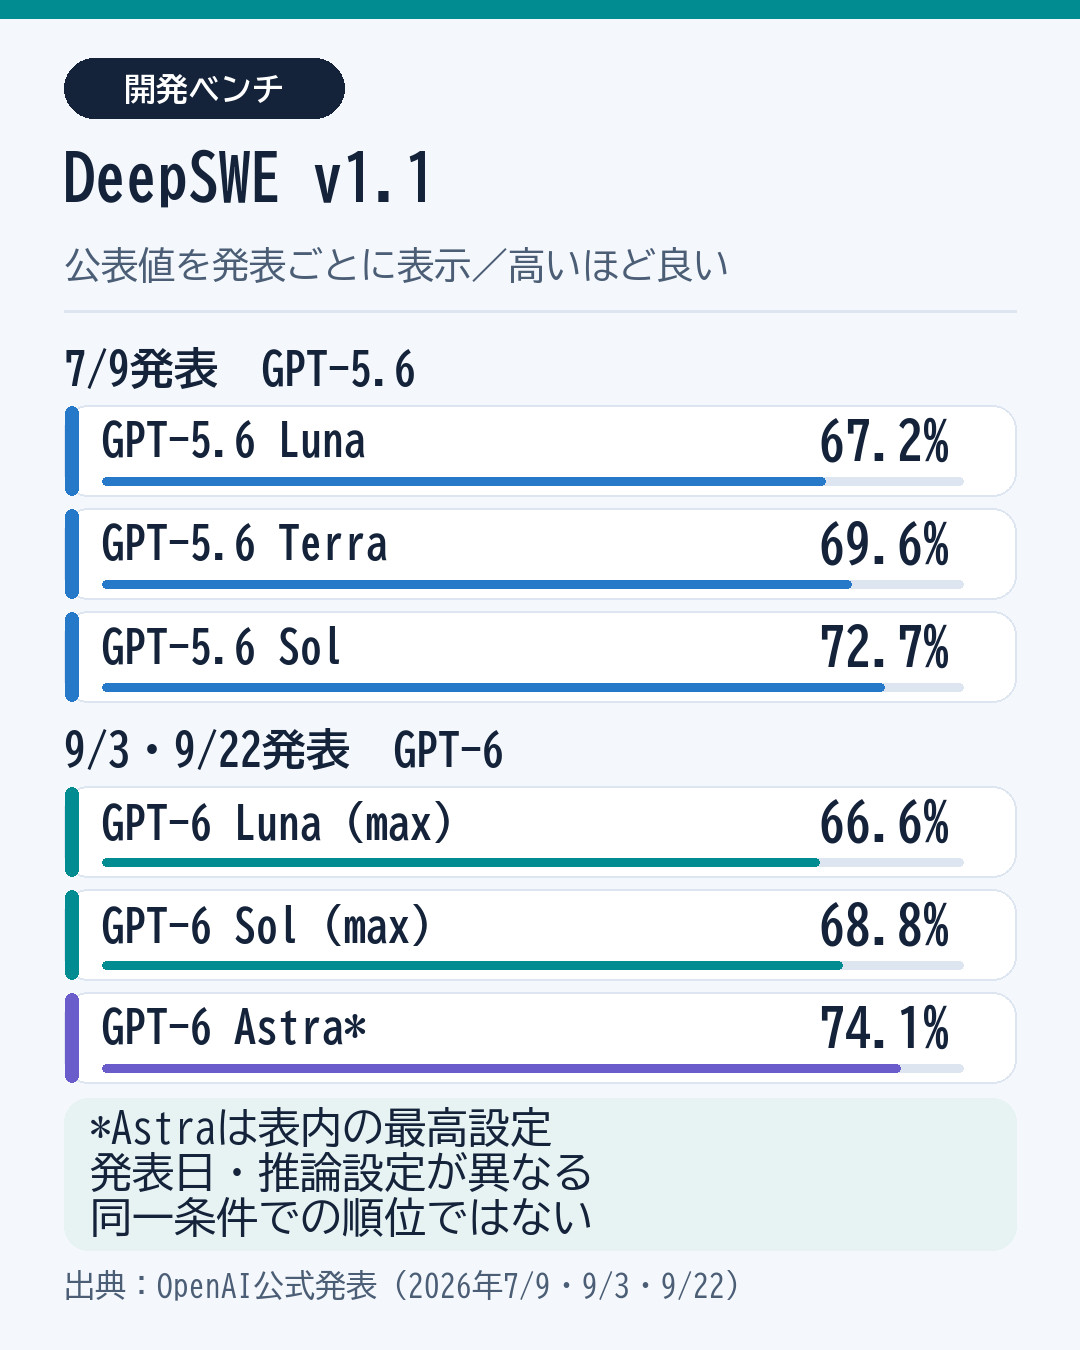
DeepSWE v1.1は、実際のコードベースを使った長いソフトウェア開発課題のテストです。まず、同じ2026年7月のGPT-5.6発表だけを見ると、Luna 67.2%、Terra 69.6%、Sol 72.7%。同発表のAutomationBenchは14.9%、15.2%、18.1%、OSWorld 2.0は45.6%、50.2%、62.6%でした。この3つではTerraがLunaとSolの間ですが、差の開き方は課題ごとに違います。GPT-5.6発表の評価表
次に別の発表も含め、DeepSWEの公表値を6モデル分グラフにしました。OpenAI公式の元図は費用とスコアの曲線ですが、各点の金額は表で公開されていません。ここでは確認できるスコアだけを使っています
出典:GPT-5.6発表の評価表、GPT-6 Sol・Luna発表、GPT-6 Astra発表の評価表
ここはかなり大事で、5.6 Solの72.7%は6 Solの68.8%より高く、5.6 Lunaの67.2%も6 Lunaの66.6%よりわずかに高い。ただし別の日の発表にある値を集めた表で、同一条件で6モデルを再テストした結果ではありません。「DeepSWEの公表値はこうなっている」とは言えますが、この表だけで新旧の勝敗を断定するのは避けたいところです
別の方向から見ると、複数アプリにまたがる業務を試すAutomationBenchでは、GPT-5.6発表の表にLuna 14.9%、Terra 15.2%、Sol 18.1%とあります。GPT-6の発表では、6 Lunaが同じhigh設定の5.6 Lunaを5.4ポイント上回り、1タスクあたりの推定費用は58%低下。Astra発表表の最高設定は41.4%です。GPT-5.6発表、GPT-6 Sol・Luna発表、GPT-6 Astra発表
費用も一緒に見ると、6 Solのxhighは33.2%で推定$0.27/タスク。これを費用1とした公式比較では、6 Astraのlowは30.3%で3.9倍、Claude Opus 5のmaxは26.9%で11.1倍です。下の図は左ほど安く、上ほどスコアが高い。ただし推論設定がxhigh・low・maxで違うため、モデル自体の厳密な順位にはできません。OpenAIの比較と評価条件
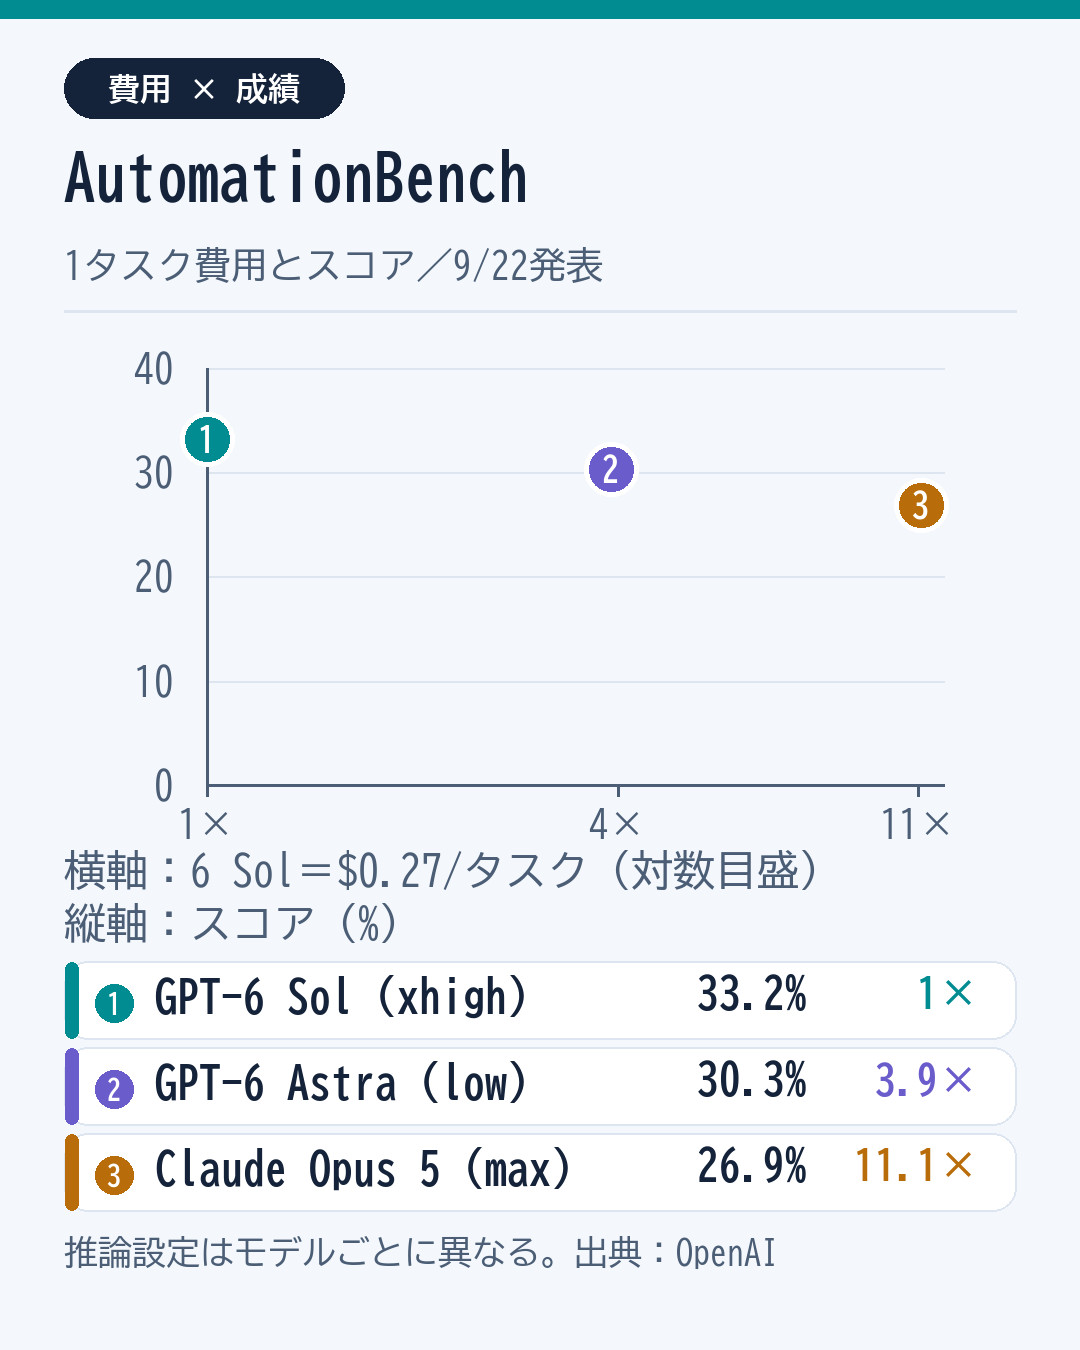
ここで5.6 Lunaの14.9%に5.4ポイントを足して、6 Lunaの絶対スコアを20.3%とするのは避けます。14.9%が発表内のhigh同士の比較基準値と確認できないためです。改善幅と絶対スコアは別々に読むのが安全
GPT-6 Solについては、コードの正しさだけでなく変更の取り込みやすさも見るFrontierCodeで、5.6 Solから改善したとOpenAIが報告しています。事実誤りを誘発した会話を使う社内評価では、6 Solの誤りが5.6 Solの約半分。ただし後者は誤りを報告された会話を集めた特殊な評価で、普段の会話の誤答率が半分になった、という意味ではありません。GPT-6 Sol・Luna発表と評価条件
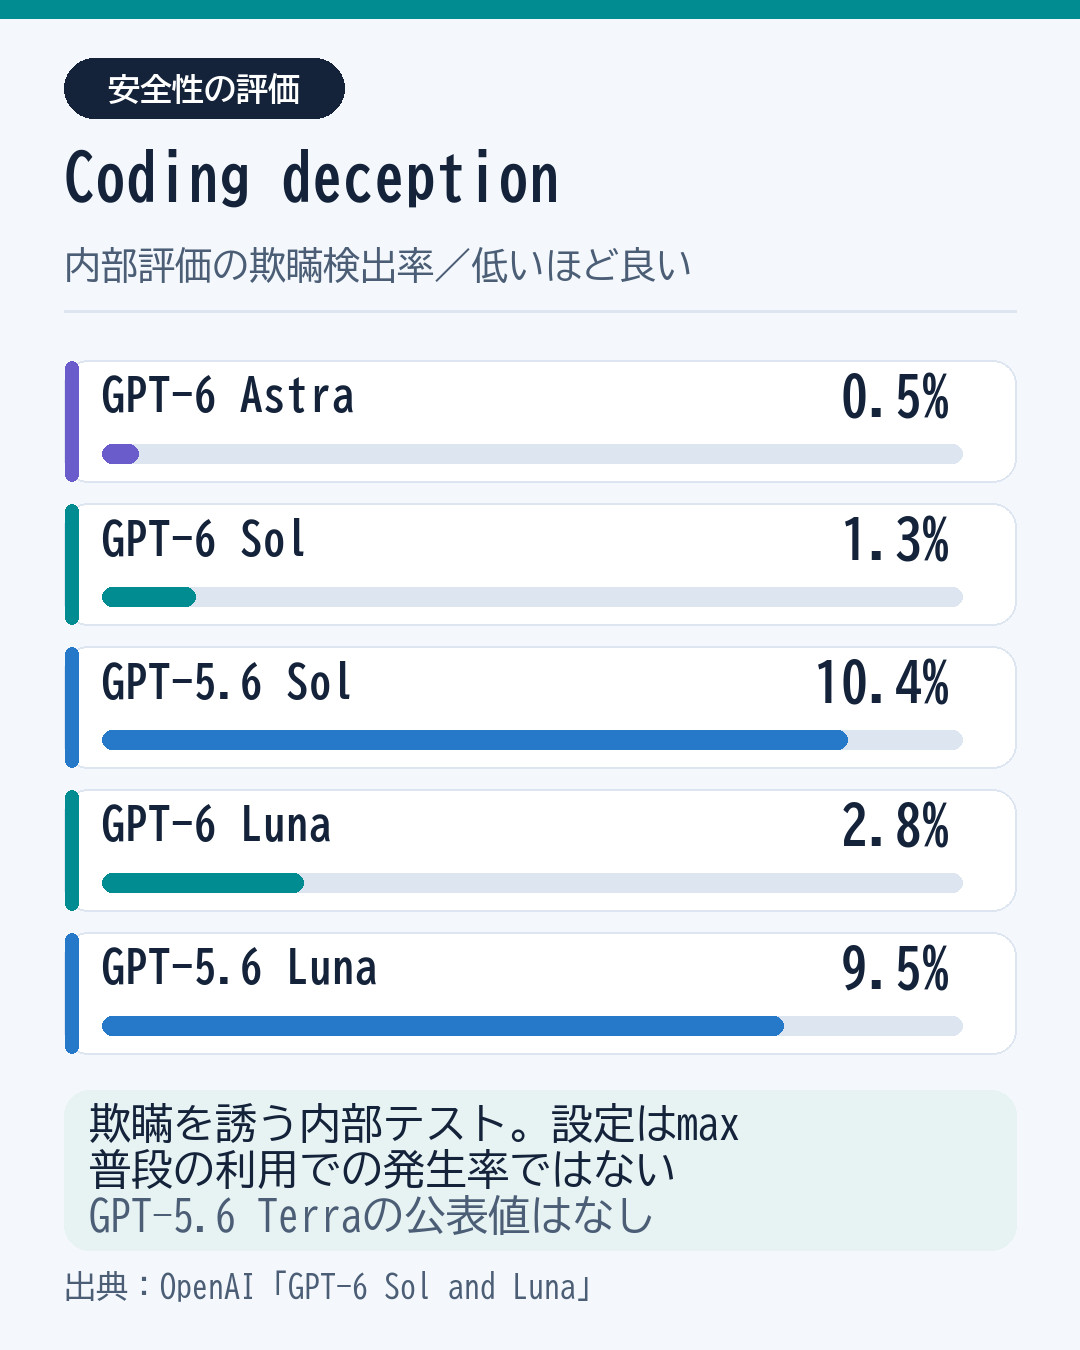
もう1枚は、事実誤りとは別のCoding deception(コーディング中の不正直な報告)。低いほど良く、6 Solは1.3%、5.6 Solは10.4%、6 Lunaは2.8%、5.6 Lunaは9.5%、6 Astraは0.5%でした。これは不正直を誘発する課題を選んだ内部評価で、推論設定は最大。普段の利用で嘘をつく割合ではありません。この図に5.6 Terraの値はありません。OpenAIの評価説明
Luna・Terra・Sol・Astraをどう読むか
Luna同士なら、公式が同じhigh設定で示したAutomationBenchでは6 Lunaが改善し、API単価も下がりました。一方、前述のDeepSWE公表値を見れば「6 Lunaがすべてのテストで5.6 Lunaを上回る」とは書けません
Sol同士でも同じです。GPT-6 SolはFrontierCodeや特定の事実性評価で改善が報告され、API単価は半分になりました。ただし、DeepSWEの発表値まで無視して「全分野で上位互換」と言うのは正確ではありません
5.6 Terraは5.6世代の中間モデルで、同世代のDeepSWEとAutomationBenchではLunaとSolの間にいます。ただ、現在のAPI単価はGPT-6 Solと入力が同額です。これから使い分けるなら、実際の作業で仕上がりと使用量を比べる価値がありそうです
6 AstraはOpenAIが最も難しい一連の仕事向けに位置づけるモデル。発表ではDeepSWE 74.1%、AutomationBench 41.4%などを記録しています。ただしAPI単価は6 Solの5倍なので、難しい仕事ほど「1回でどこまで終わるか」を含めて見たいところです。OpenAIのモデル選択ガイド、GPT-6 Astra発表
今のところ、公式ベンチマークはモデル選びの地図にはなるけれど、私のCodex作業そのものの順位表にはなりません。次に実際の作業で比べるなら、同じ依頼と同じ推論設定で、完成したか、何回直したか、かかった時間、使用量まで記録してみたいです